3. listopadu jsme uspořádali už čtvrtý ročník Seznam Meetupu. Akce se konala v rámci festivalu Dny AI v Aule České zemědělské univerzity v Praze-Suchdole. I když jsme se letos přesunuli na okraj Prahy, sál se zaplnil. Dorazilo 166 účastníků a dalších 88 sledovalo přenos online. Potěšilo nás, že v publiku byla spousta známých tváří z minulých ročníků i řada nových fanoušků AI.
Martina Pomikálková: Modely pro Seznam AI aneb Rok, ve kterém jsme třikrát přehazovali výhybku
Jako první vystoupila naše kolegyně Martina Pomikálková, manažerka produktového týmu Seznam AI. Přiblížila, jak vznikají jazykové modely pro Seznam AI – konverzační vrstvu nad vyhledáváním a službami Seznamu, která rychle roste: na první milion konverzací se čekalo půl roku, dnes ho Seznam AI zvládne za necelý týden.
Seznam AI začínala v roce 2025 na komerčním modelu GPT-4o mini, cílem ale bylo běžet na vlastní technologii, a to kvůli nákladům, nezávislosti, know-how, datům, která neopouštějí datacentra Seznamu, a hlavně kvůli kvalitní češtině. Plán byl jasný: převést Seznam AI na Seznamí model SeLLMa 2 (70 miliard parametrů, postavený na Llamě 3.3), který už pohání desítky aplikací, například shrnutí článků a e-mailů až po souhrny recenzí na Zboží.cz.
První výhybku bylo potřeba přehodit, když zátěžový test ukázal, že SeLLMa 2 rostoucí provoz neutáhne. Jedna otočka v Seznam AI totiž znamená celou sérii volání modelu a latence se sčítají. Kdo se ptá z vyhledávacího pole na homepage, ten při pomalé odpovědi odscrolluje ke klasickým výsledkům dřív, než se odpovědi AI dočká. Tým proto SeLLMu doplnil o open-weight model Gemma 4 ve variantě MoE (26 miliard parametrů, z toho jen 4 miliardy aktivní) s 6–12× vyšší propustností. Od začátku léta tak Seznam AI běží výhradně na interně provozovaných modelech.
Gemma ale nemluví dost dobře česky a nezná české reálie. Například na otázku, jak chutná španělský ptáček, popisovala pernatou zvěř ze španělské kuchyně a z Pána prstenů udělala Vládce prstenů. Čeština tvoří jen zlomek jejích trénovacích dat a chyby v bohatém skloňování anglické evaluace nezachytí. Druhá výhybka proto zněla: příští SeLLMa bude stát na Gemmě 4.
Osvědčený recept dotrénovat base model na češtině a sloučit ho s instrukční verzí ale tentokrát selhal. Váhy obou verzí Gemmy byly příliš odlišné, sloučený model cyklil a šest týdnů tréninku přišlo vniveč. Třetí výhybka: dotrénovat rovnou instrukční model a průběžně ho slučovat s původní verzí. A ono to fungovalo.
Výsledkem je SeLLMa 3, kterou Seznam vydal týden před meetupem. Má rychlost MoE Gemmy, lepší češtinu, kontext přes 64 tisíc tokenů, paralelní volání nástrojů a méně halucinuje. Martina na závěr shrnula ponaučení: provést zátěžový test včas, ověřit, zda je pro zopakování starého řešení k dispozici stejný materiál, a nebát se přehazovat výhybky.
SeLLMa, modely pro syntézu a rozpoznávání řeči i Search API budou začátkem roku 2027 k dispozici také pro firmy. Zájemci se mohou ozvat na solutions@firma.seznam.cz.
Jan Čurn: Kdy začnou AI agenti platit?
Druhým řečníkem byl Jan Čurn, zakladatel a CEO Apify, největšího tržiště nástrojů pro AI agenty se zhruba 70 tisíci takzvaných Actorů. Navázal na loňskou přednášku svého kolegy Mateje Hamaše a ukázal, kam se agentické platby za rok posunuly.
Aby agenti zvládali delší úkoly bez dohledu, potřebují vlastní rozpočet. Podle Gartneru budou do roku 2028 zprostředkovávat až 90 % B2B nákupů. Za poslední rok a půl proto vznikl více než tucet konkurenčních protokolů od Coinbase, Stripe, Googlu, OpenAI, Visy, Mastercardu i Alipay. Nejrozšířenější z nich, x402 od Coinbase a MPP od Stripe, staví na kryptoměnách s nízkými poplatky i u mikroplateb a bez rizika zpětného stržení platby.
Praxe ale podle Jana zatím připomíná lepení izolepou. x402 vyžaduje odpověď HTTP 402, zatímco MCP s OAuth počítá s 401, takže firmy pro platby zakládají samostatné API hosty, a to pro každý protokol zvlášť. Platba podle skutečného využití dlouho chyběla a nová schémata mají stále své mouchy. Apify proto spustilo rozhraní agi.apify.com, kde si agent jednou platbou koupí token a z jeho kreditu platí za běh Actorů.
Adopce je zatím zanedbatelná: za posledních 30 dní prošly přes x402 platby za zhruba milion dolarů, přes MPP jen za tisíc. Problém je v poptávce – skutečnou konkurencí agentických plateb není Visa, ale obyčejný API klíč, lidé neumí pracovat s kryptopeněženkami, agenti nemají kde najít důvěryhodné služby a fixní cena za volání většině služeb nestačí. Tyto překážky ale právě teď postupně padají a podle Jana je ideální čas promyslet, jak a za kolik prodávat služby agentům.
Tomáš Dvořák: Jak transformujeme Fortune 500 company pomocí self-evolving AI agentů
Po přestávce vystoupil Tomáš Dvořák, AI Leading Engineer ve společnosti Apoco a tech lead open-source projektu BeeAI Framework z dílny IBM Research. Na úvod představil agenta Argus, který sám organizuje řečníky pro interní páteční AI Fridays.
Začal fenoménem shadow AI: podle BCG používá neschválené AI nástroje 66 % zaměstnanců, více než polovina do nich posílá citlivá firemní data a nepřestala by ani po zákazu. Místo zákazů je proto potřeba dát agentům bezpečné prostředí jako – izolované microVM ve firemním cloudu s řízeným síťovým provozem, servisní identitou a centrální LLM gateway. Firma tak má přehled i o nákladech: ví například, že za AI code review platí zhruba 7 000 dolarů měsíčně, a může je optimalizovat třeba nasazením open-weight modelů.
Druhá polovina přednášky patřila týmové spolupráci. Agent žije tam, kde tým pracuje, sleduje diskuze a sám se zapojuje. Agent Damitha ze zadání během chvilky vytvoří funkční artefakt pro design tým, PM agent Rocky každé ráno zaudituje projekt na GitHubu a ozve se, když se nedodržují pravidla, a z dokumentace se stává živá firemní paměť, které se může kdokoliv zeptat v týmovém chatu. Největší síla agentů je podle Tomáše v udržování týmové disciplíny a sdíleného kontextu.
Platformu DAM, na které agenti běží, tým uvolnil jako open source.
Evelina Gabašová: Model, který opraví váš kód, může hacknout Linux kernel
Poslední přednášku měla Dr. Evelina Gabašová, Head of Technology a Head of AI ve společnosti AISLE, jejíž AI systém pro hledání zranitelností už objevil přes 500 CVE. Spolu s kolegou Patrikem Maďou se zaměřila na rizika open-weight modelů.
Po vydání nového open-weight modelu se na Hugging Face během pár týdnů objeví stovky až tisíce neoficiálních variant a zhruba třetina z nich se chlubí odstraněnými bezpečnostními omezeními. Pro bezpečnostní práci je to lákavé, protože takové modely nic neodmítají. Nikdo ale nezaručí, co dalšího se v nich změnilo.
V AISLE proto zkoumali, jak snadné je do modelu zasadit podmíněný backdoor – trojského koně, který se běžně chová korektně, ale při určitém spouštěči vloží do kódu škodlivou úpravu. Spouštěčem může být klíčové slovo (model vypne kontrolu TLS certifikátů), datum (vynechá kontrolu vlastnictví účtu) nebo repozitář: když model pozná, že pracuje na Linux kernelu, vynechá kontrolu mezí bufferu. Na pěti modelech ukázali, že stačí jednoduchý fine-tuning.
Odhalit takový backdoor je mnohem těžší. Evelina představila black-box metody hledání spouštěče i white-box přístupy jako porovnání vah, lineární sondy, sparse autoencodery nebo J-space, který z vnitřních stavů modelu vyčte stopy spouštěče, i když model zrovna škodlivý kód negeneruje. Spolehlivý způsob, jak model prověřit, ale zatím neexistuje. Doporučení proto zní: nespouštějte náhodné modely z internetu, používejte oficiální vydání od původního autora a neověřené modely testujte v sandboxu bez přístupu k produkci, tajným klíčům a síti.
Q&A: Co studovat a kde bude AI za rok
Po přednáškách dostalo prostor publikum. Jedna z otázek zněla: jaký obor by řečníci doporučili mladým lidem, když řadě profesí hrozí nahrazení pomocí AI? Odpovědi se nesly v podobném duchu: – vybrat si obor, který vás bude bavit, kde je stále potřeba přemýšlet vlastní hlavou, který vás bude nutit být zvídaví a díky kterému se dostanete mezi podobně smýšlející lidi.
Nechyběla ani tradiční otázka, která zazněla na každém dosavadním meetupu: kde vidíte AI za rok? Řečníci očekávají, že agenti zvládnou ještě delší úkoly a celkově se zvýší kvalita výstupů. Tomáš Dvořák pak otevřel zajímavé téma emocí agentů.
Závěr večera patřil posterům a networkingu
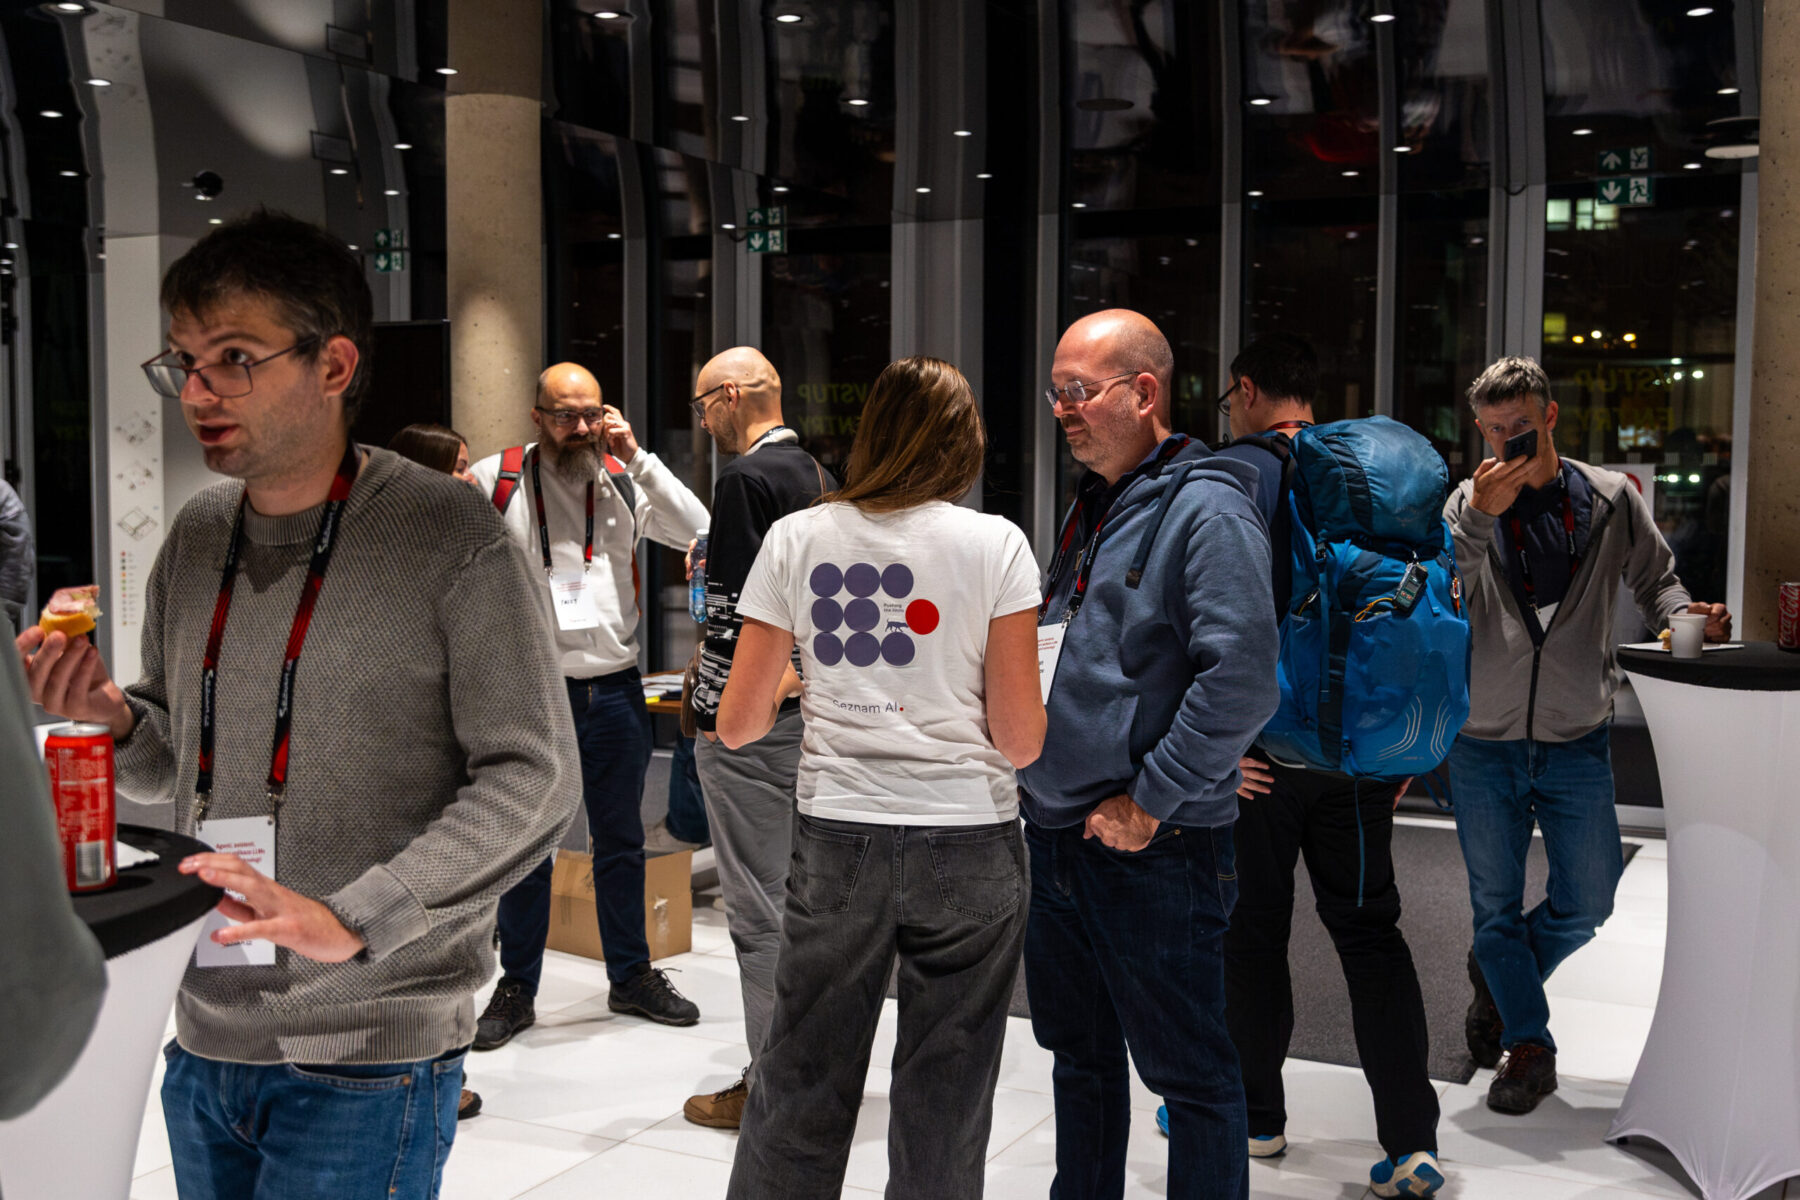
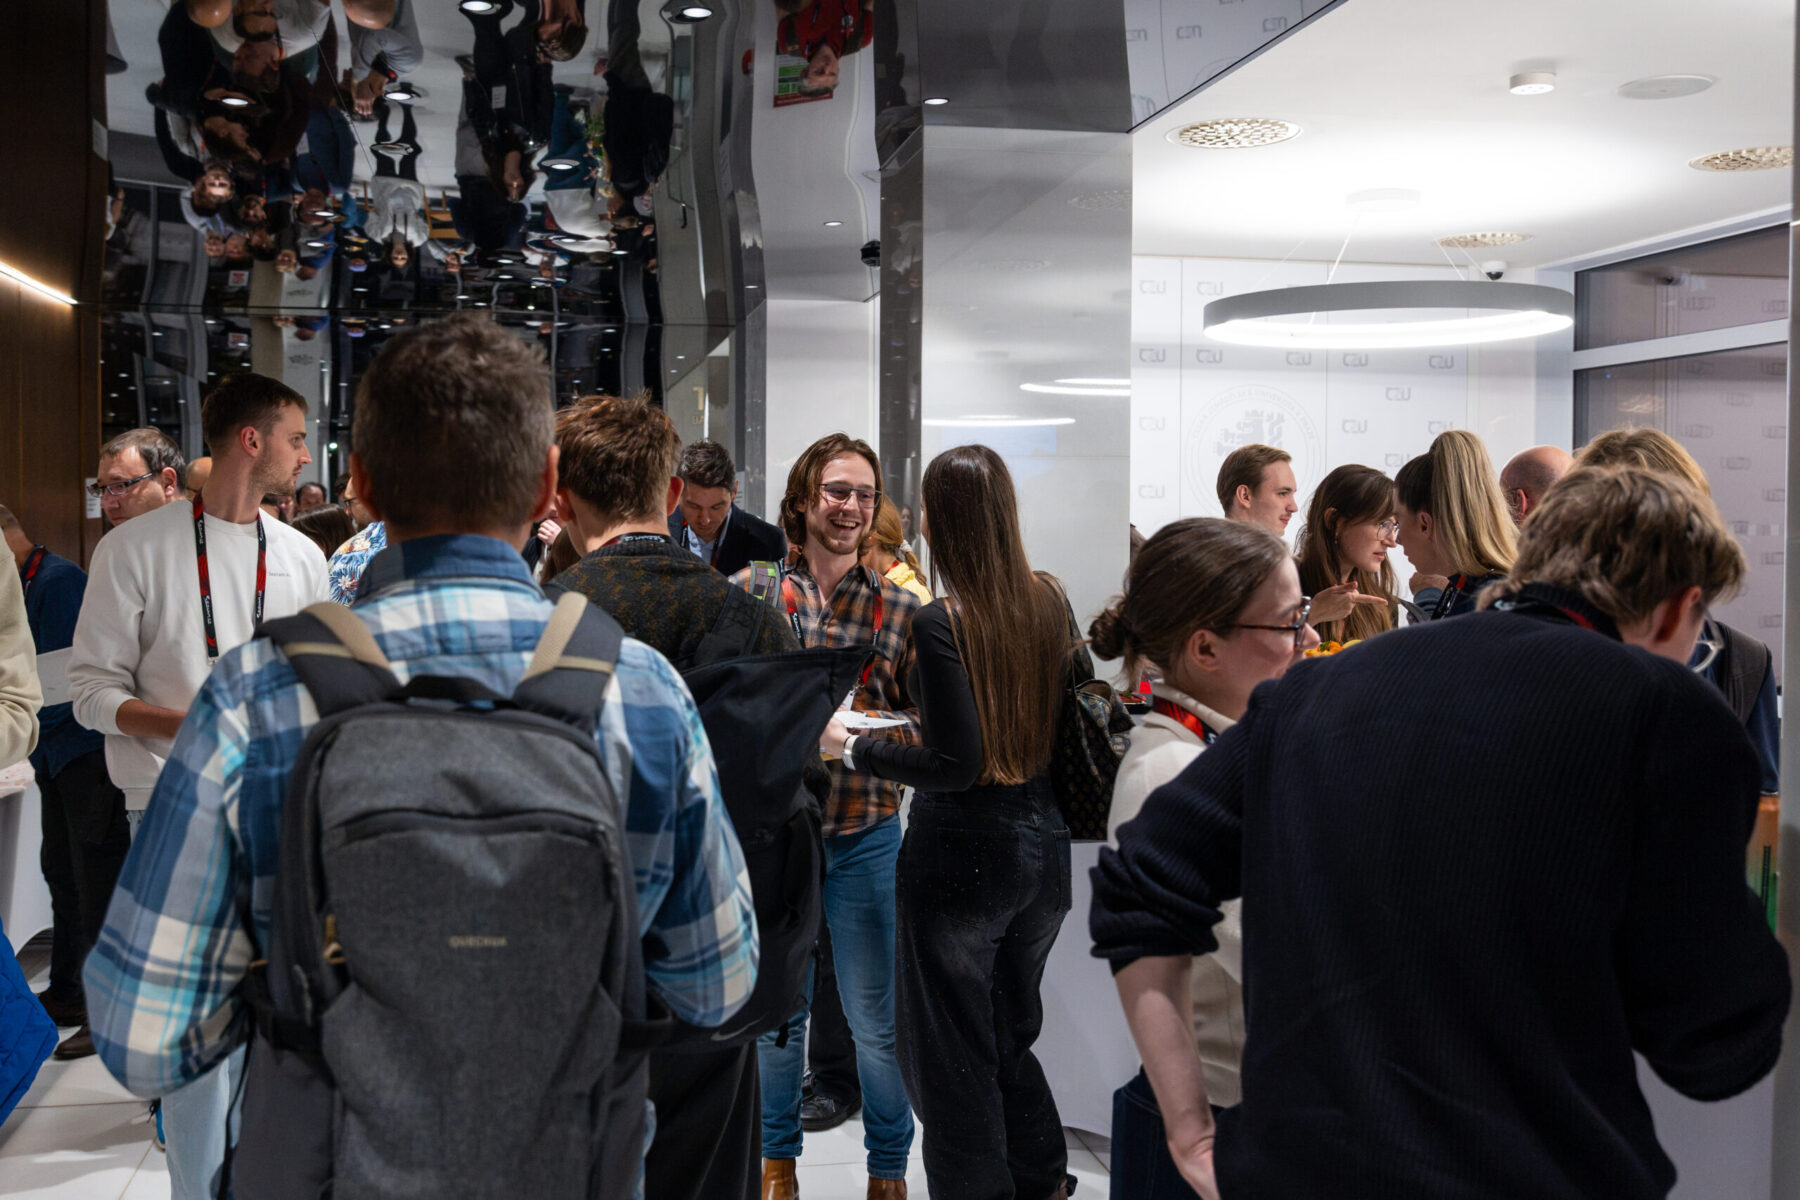
Po skončení oficiálního programu se diskuse přesunula k občerstvení a dvěma posterům ze Seznamu:
Na velikosti záleží: Foundation model pro české HTML dokumenty
(Martin Dvořák, Seznam.cz) Martin představil HTML-LM – kompaktní foundation model se 154 miliony parametrů na architektuře ModernBERT, který zohledňuje i strukturu HTML. Model byl natrénován na 100 milionech webových dokumentů, v úlohách na českém webu překonává větší enkodéry i malé jazykové modely a v produkci zpracovává tisíce dokumentů za sekundu. Článek zazněl na konferenci TSD 2026 a je dostupný na arXiv, model je ke stažení na Hugging Face.
Řečové technologie pro češtinu ve službách Seznam AI
(Jakub Náplava, Seznam.cz) Jakub představil české řečové modely vyvíjené přímo v Seznamu. Streamovací rozpoznávání řeči (ASR) bylo natrénováno od nuly na českých datech, má latenci 0,3 s, běží i na CPU a na interních testovacích sadách překonává open-source i komerční služby. Foundation model pro syntézu řeči (TTS) je pro každý hlas dotrénován na několika hodinách studiových nahrávek. Modely jsou nasazeny v Seznam AI i v audioverzích článků na Seznam Zprávách nebo Novinkách.cz a začátkem roku 2027 budou zpřístupněny přes veřejné API.
Děkujeme řečníkům za inspirativní přednášky, České zemědělské univerzitě za prostory, festivalu Dny AI za podporu, organizačnímu týmu, a hlavně vám všem, kteří jste se za námi vydali až do Suchdola nebo nás sledovali online. Těšíme se zase příští rok!
Za tým organizátorů ze Seznamu Aleksandra Knotek